
Отказоустойчивая инфраструктура: как распределить сервисы между зонами доступности
Если сервис работает в одном дата-центре, резервные копии сами по себе не защищают от простоя. При отказе питания, сети или инженерных систем данные можно восстановить, но на это потребуется время — иногда часы. Для интернет-банка, платежного сервиса или маркетплейса такой перерыв означает остановку операций.
Чтобы сервис продолжал работать при отказе площадки, его компоненты заранее распределяют между независимыми доменами отказа, настраивают репликацию данных и переключение трафика. Уровень резервирования выбирают под конкретную систему — по допустимому времени простоя, требованиям к сохранности данных и бюджету.
Что такое зона доступности и чем она отличается от региона
Зона доступности — это изолированный инфраструктурный домен внутри региона. В Servercore зоны размещаются на отдельных площадках с собственными системами электропитания, охлаждения и сетевого подключения. Зоны проектируют так, чтобы отказ одной площадки не приводил к недоступности остальных зон региона.
Иерархию можно представить так:
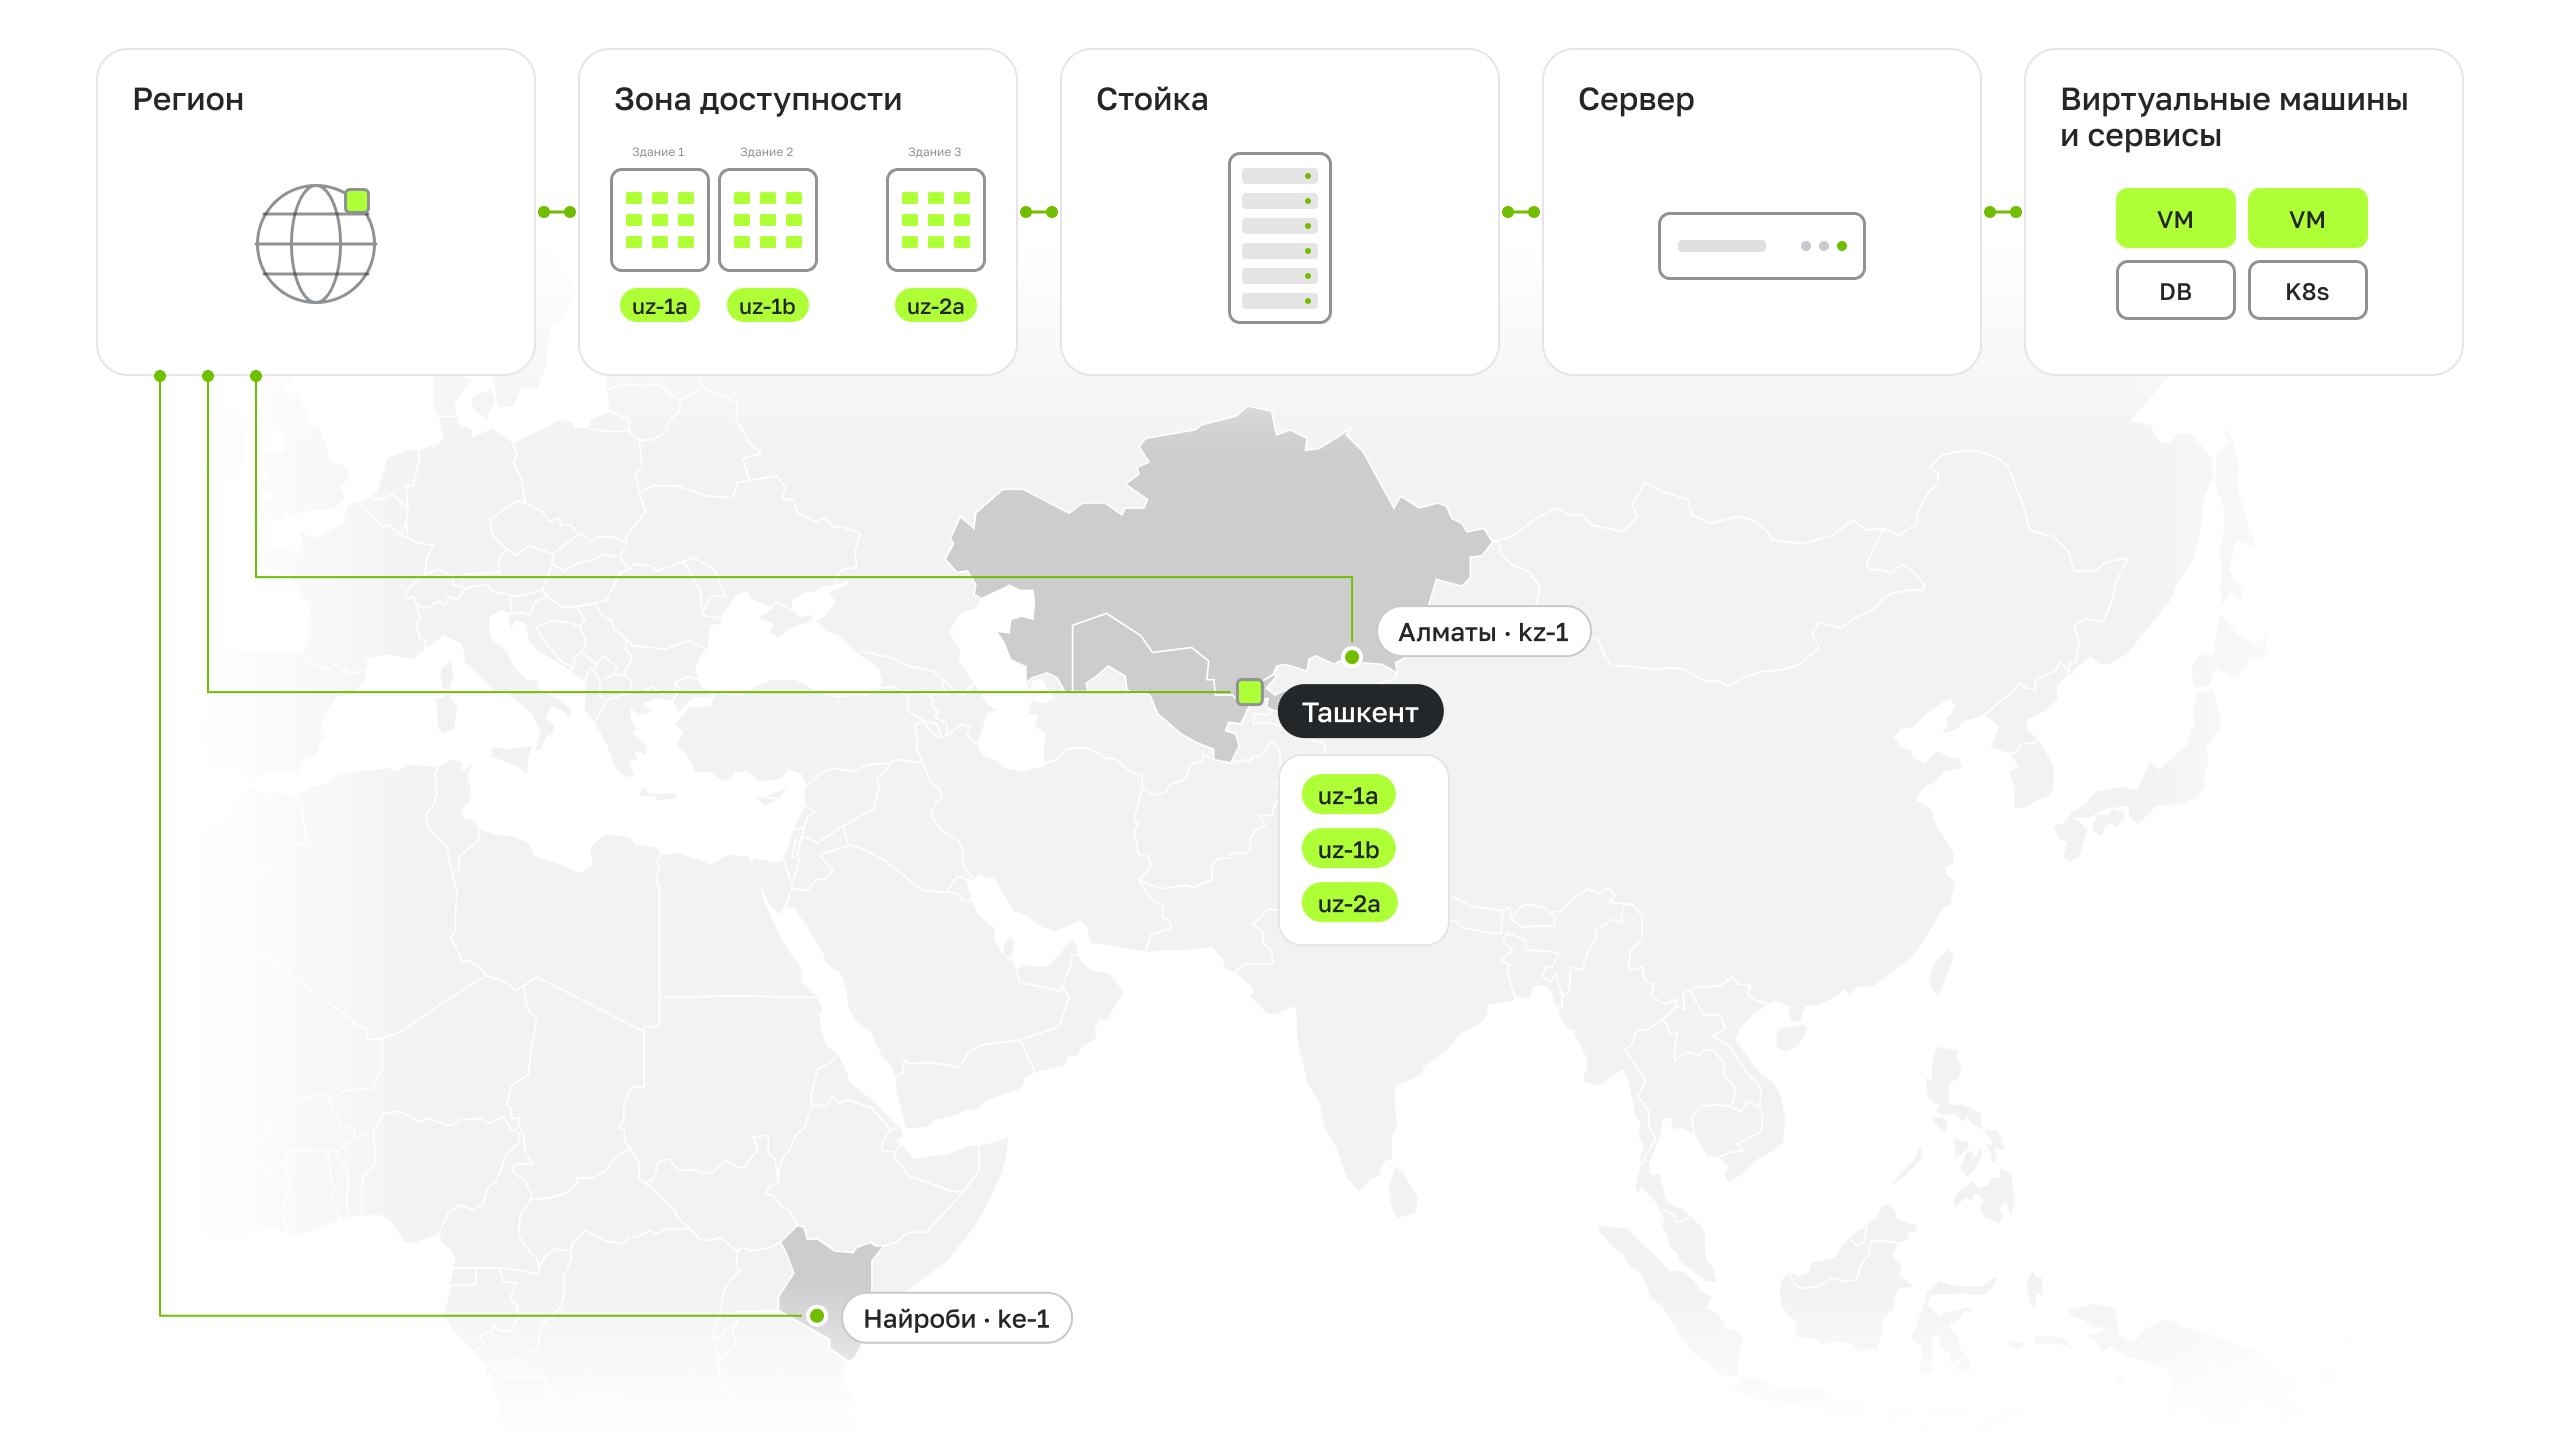
Регион — географическая область, внутри которой может быть одна или несколько зон доступности. Площадки одного региона расположены достаточно близко и связаны сетью с низкой задержкой. Разные регионы, наоборот, географически разнесены, поэтому обмен данными между ними занимает больше времени.
Масштаб отказа определяет, где должен находиться резерв. Вторая виртуальная машина на соседнем хосте защищает от отказа сервера, но не от аварии в дата-центре. Чтобы пережить аварию на площадке без остановки бизнес-операций, критичные компоненты нужно заранее разместить в другой зоне.
Если сервис распределен между несколькими зонами одного региона, такую архитектуру называют Multi-AZ. Мультирегиональная схема использует несколько географически разнесенных регионов и рассчитана на более крупные сценарии отказа.
В Центральной Азии и Кении у Servercore пять зон доступности: одна в Алматы, три в Ташкенте и одна в Найроби. В панели управления и документации ресурсы привязаны к пулам и сегментам.
Пул — часть инфраструктуры, изолированная от аппаратных и программных сбоев в других пулах; для облачной инфраструктуры пул делится на сегменты. Однозональный пул размещается в одном дата-центре, и его сегменты различаются стойками. Мультизональный пул размещается в нескольких дата-центрах разных зон доступности, и его сегменты разнесены по площадкам.
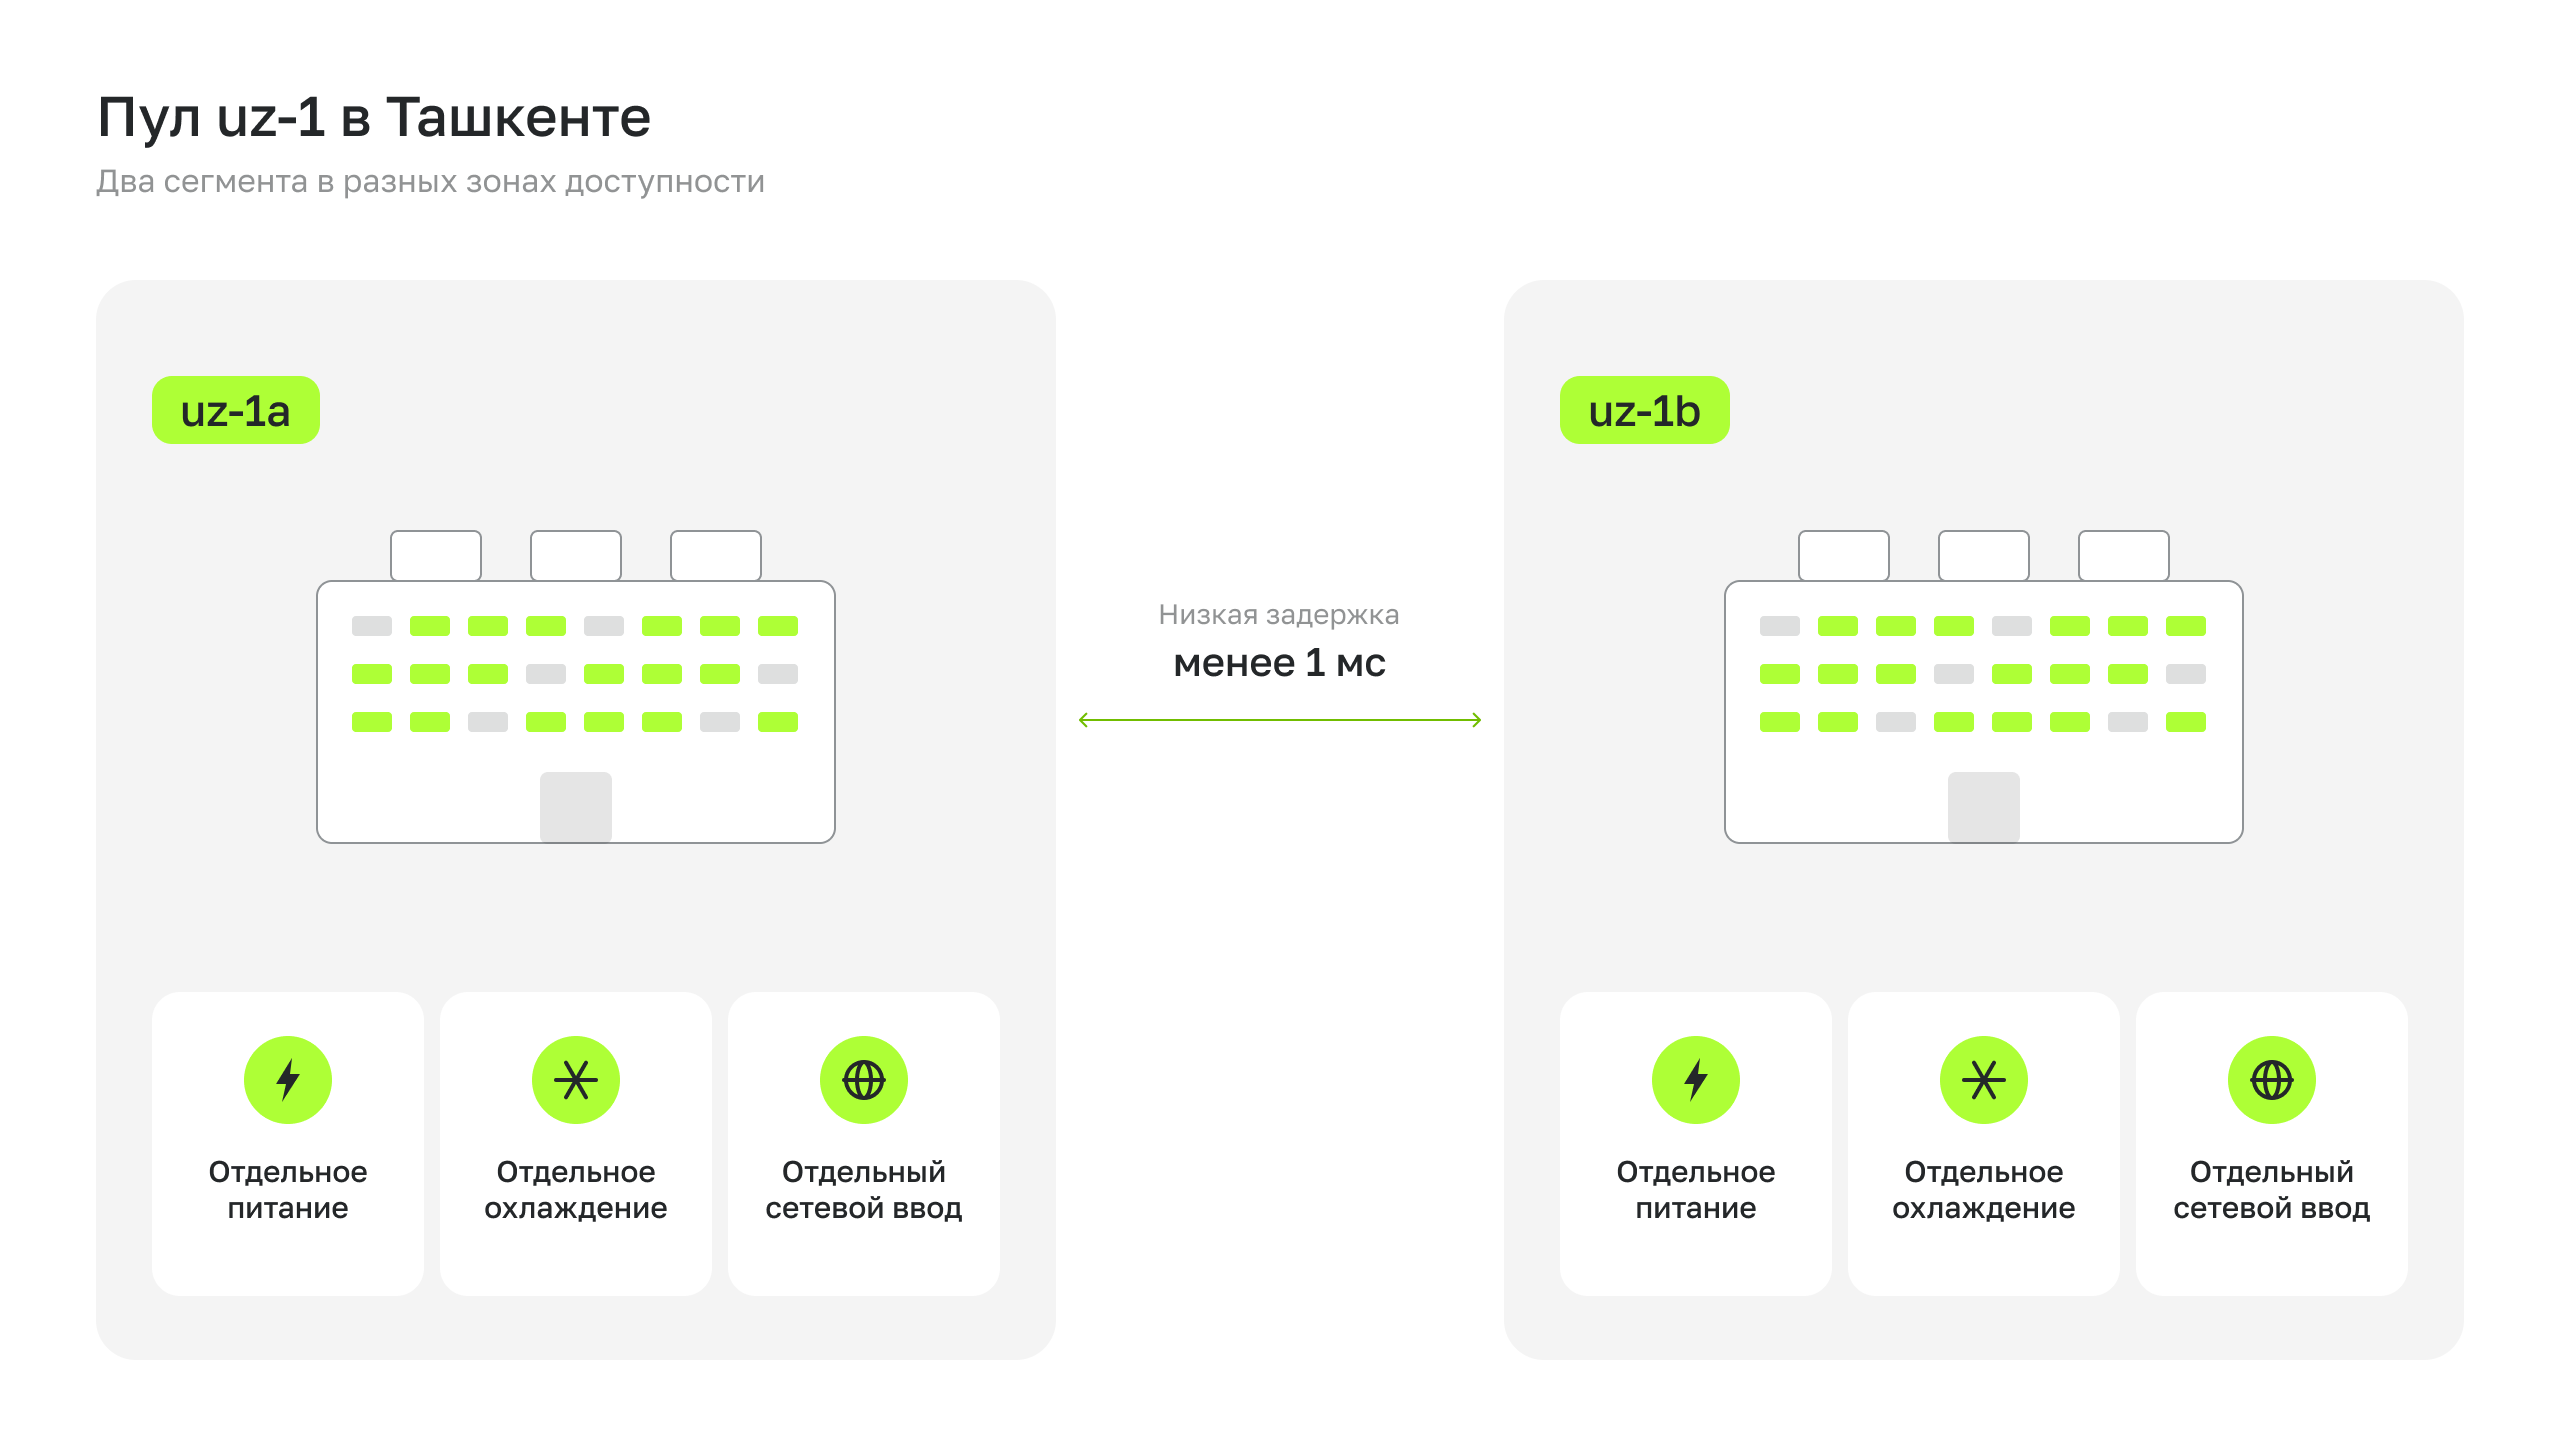
Пул uz-1 — мультизональный: сегмент uz-1a находится в первой зоне доступности Ташкента, uz-1b — в третьей. Внутри региона зоны можно использовать для распределения компонентов одной системы, если это поддерживает архитектура приложения.
От чего защищает распределение инфраструктуры по зонам
Мультизональная архитектура уменьшает зависимость сервиса от одной физической площадки. Если рабочие экземпляры приложения и актуальные данные есть во второй зоне, отказ оборудования, сети или инженерных систем одного дата-центра не останавливает сервис целиком.
Но зоны доступности закрывают только инфраструктурные отказы. Ошибочный релиз, неверная конфигурация или удаление данных могут одновременно затронуть все зоны.
| Тип отказа | Помогают ли зоны |
| Отказ питания, охлаждения или сети на площадке | Да, если сервис уже работает в другой зоне |
| Аппаратный отказ сервера или стойки | Да, при корректном разнесении компонентов |
| Ошибка в релизе, установленном во всех зонах | Нет |
| Логическое повреждение или удаление данных | Нет, нужны бэкапы |
| Ошибка конфигурации, реплицированная на все узлы | Нет |
| Потеря связи между зонами | Частично: нужны кворум и предусмотренный сценарий деградации |
| Событие регионального масштаба | Нет, нужен географически независимый резерв |
Поэтому Multi-AZ, резервные копии и процедуры аварийного восстановления решают разные задачи. Зоны помогают пережить отказ инфраструктуры площадки, бэкапы — вернуть корректные данные после логической ошибки, а регламенты и тесты — убедиться, что переключение действительно сработает.
Четыре уровня резервирования: от одной зоны до нескольких городов
Требования к отказоустойчивости обычно формулируют через две метрики:
- RTO (Recovery Time Objective) — сколько времени сервис может оставаться недоступным после сбоя;
- RPO (Recovery Point Objective) — какой объем последних данных допустимо потерять при восстановлении.
Чем меньше RTO и RPO, тем больше компонентов нужно держать в готовом резерве еще до аварии.
Одна зона + резервные копии
Базовый вариант — разместить сервис в одной зоне и регулярно создавать резервные копии. Он подходит для систем, где допустим перерыв на восстановление: тестовых сред, внутренних приложений и некритичных сервисов.
При потере площадки инфраструктуру придется развернуть заново в другом месте и вернуть данные из последней копии. RTO здесь складывается из времени на развертывание и восстановление, а RPO равен интервалу между резервными копиями. Высокую доступность такая схема не обеспечивает.
Две зоны внутри одного региона
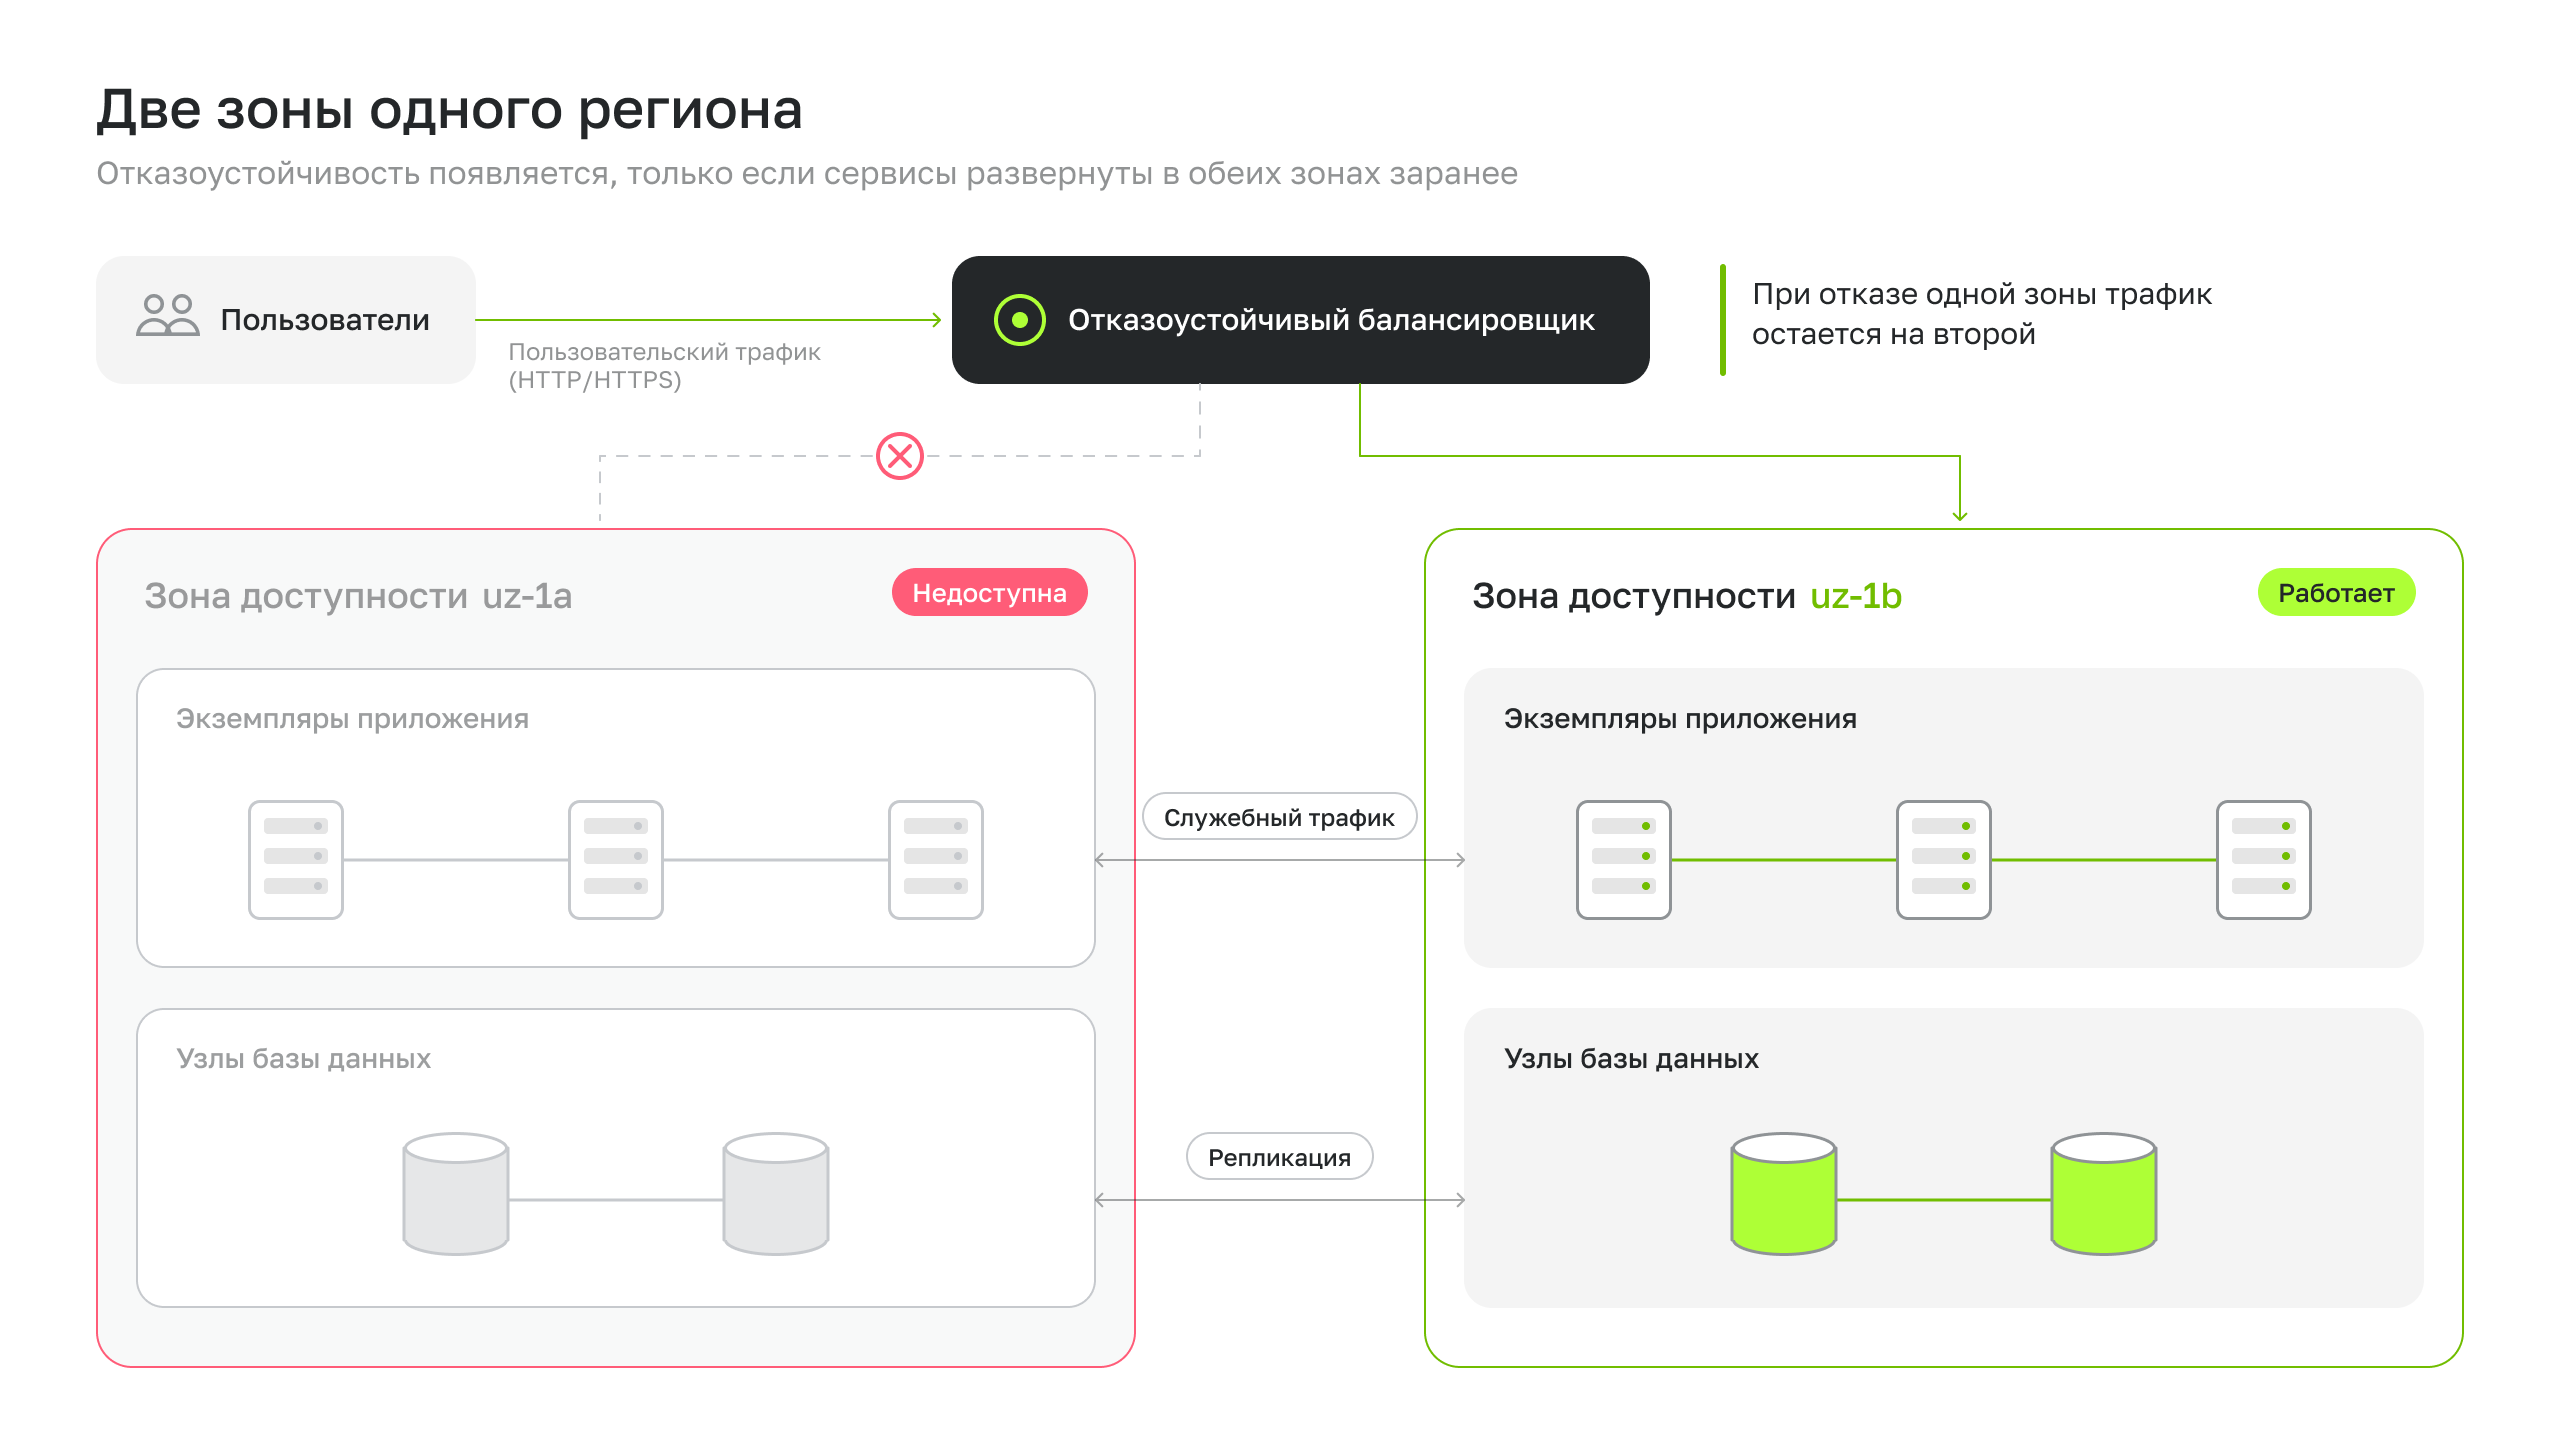
Чтобы сервис продолжал работать при недоступности площадки, его критичные компоненты размещают сразу в двух зонах. Экземпляры приложения работают на обеих площадках, балансировщик направляет запросы на доступные узлы, а данные реплицируются между зонами. При корректно настроенном failover — аварийном переключении — отказ одной зоны не останавливает сервис целиком.
Так устроен, например, мультизональный пул uz-1 в Ташкенте: сегменты uz-1a и uz-1b находятся на отдельных площадках и связаны единой сетью с низкой задержкой. Между ними можно распределить облачные серверы, узлы кластера Managed Kubernetes или реплики облачной базы данных. Если одна площадка недоступна, рабочая часть системы остается во второй зоне — при условии, что все зависимости тоже зарезервированы.
Вторая зона не создает отказоустойчивость автоматически. Если приложение и база данных по-прежнему работают только в uz-1a, наличие ресурсов в uz-1b не поможет: их придется разворачивать уже после аварии.
Разные регионы
Для защиты от события, которое может затронуть весь регион, резерв размещают географически отдельно — в другом городе или стране. Из-за большей сетевой задержки такие площадки чаще проектируют как самостоятельные контуры, а данные передают асинхронно.
Резерв может быть активным и принимать часть нагрузки постоянно либо использоваться как DR-площадка — контур аварийного восстановления. Такая схема покрывает более широкий набор отказов, но требует отдельно спроектировать межрегиональную маршрутизацию, репликацию данных и механизм переключения. При асинхронной репликации RPO обычно ненулевой: часть последних изменений может не успеть попасть на резерв.
Гибрид: облако + собственная площадка
Если у компании уже есть собственная инфраструктура или часть данных должна оставаться на собственной площадке, облако можно использовать как основной или резервный контур. Площадки связывают на сетевом уровне — например, через Direct Connect, — а способ репликации выбирают по требованиям приложения и допустимой задержке.
Такой вариант позволяет задействовать уже купленное оборудование и отдельно размещать нагрузки с особыми требованиями — например, по локализации данных, изоляции или регуляторным ограничениям. Но и здесь отказоустойчивость дает не сам факт наличия двух площадок, а то, как устроены данные, маршрутизация и failover.
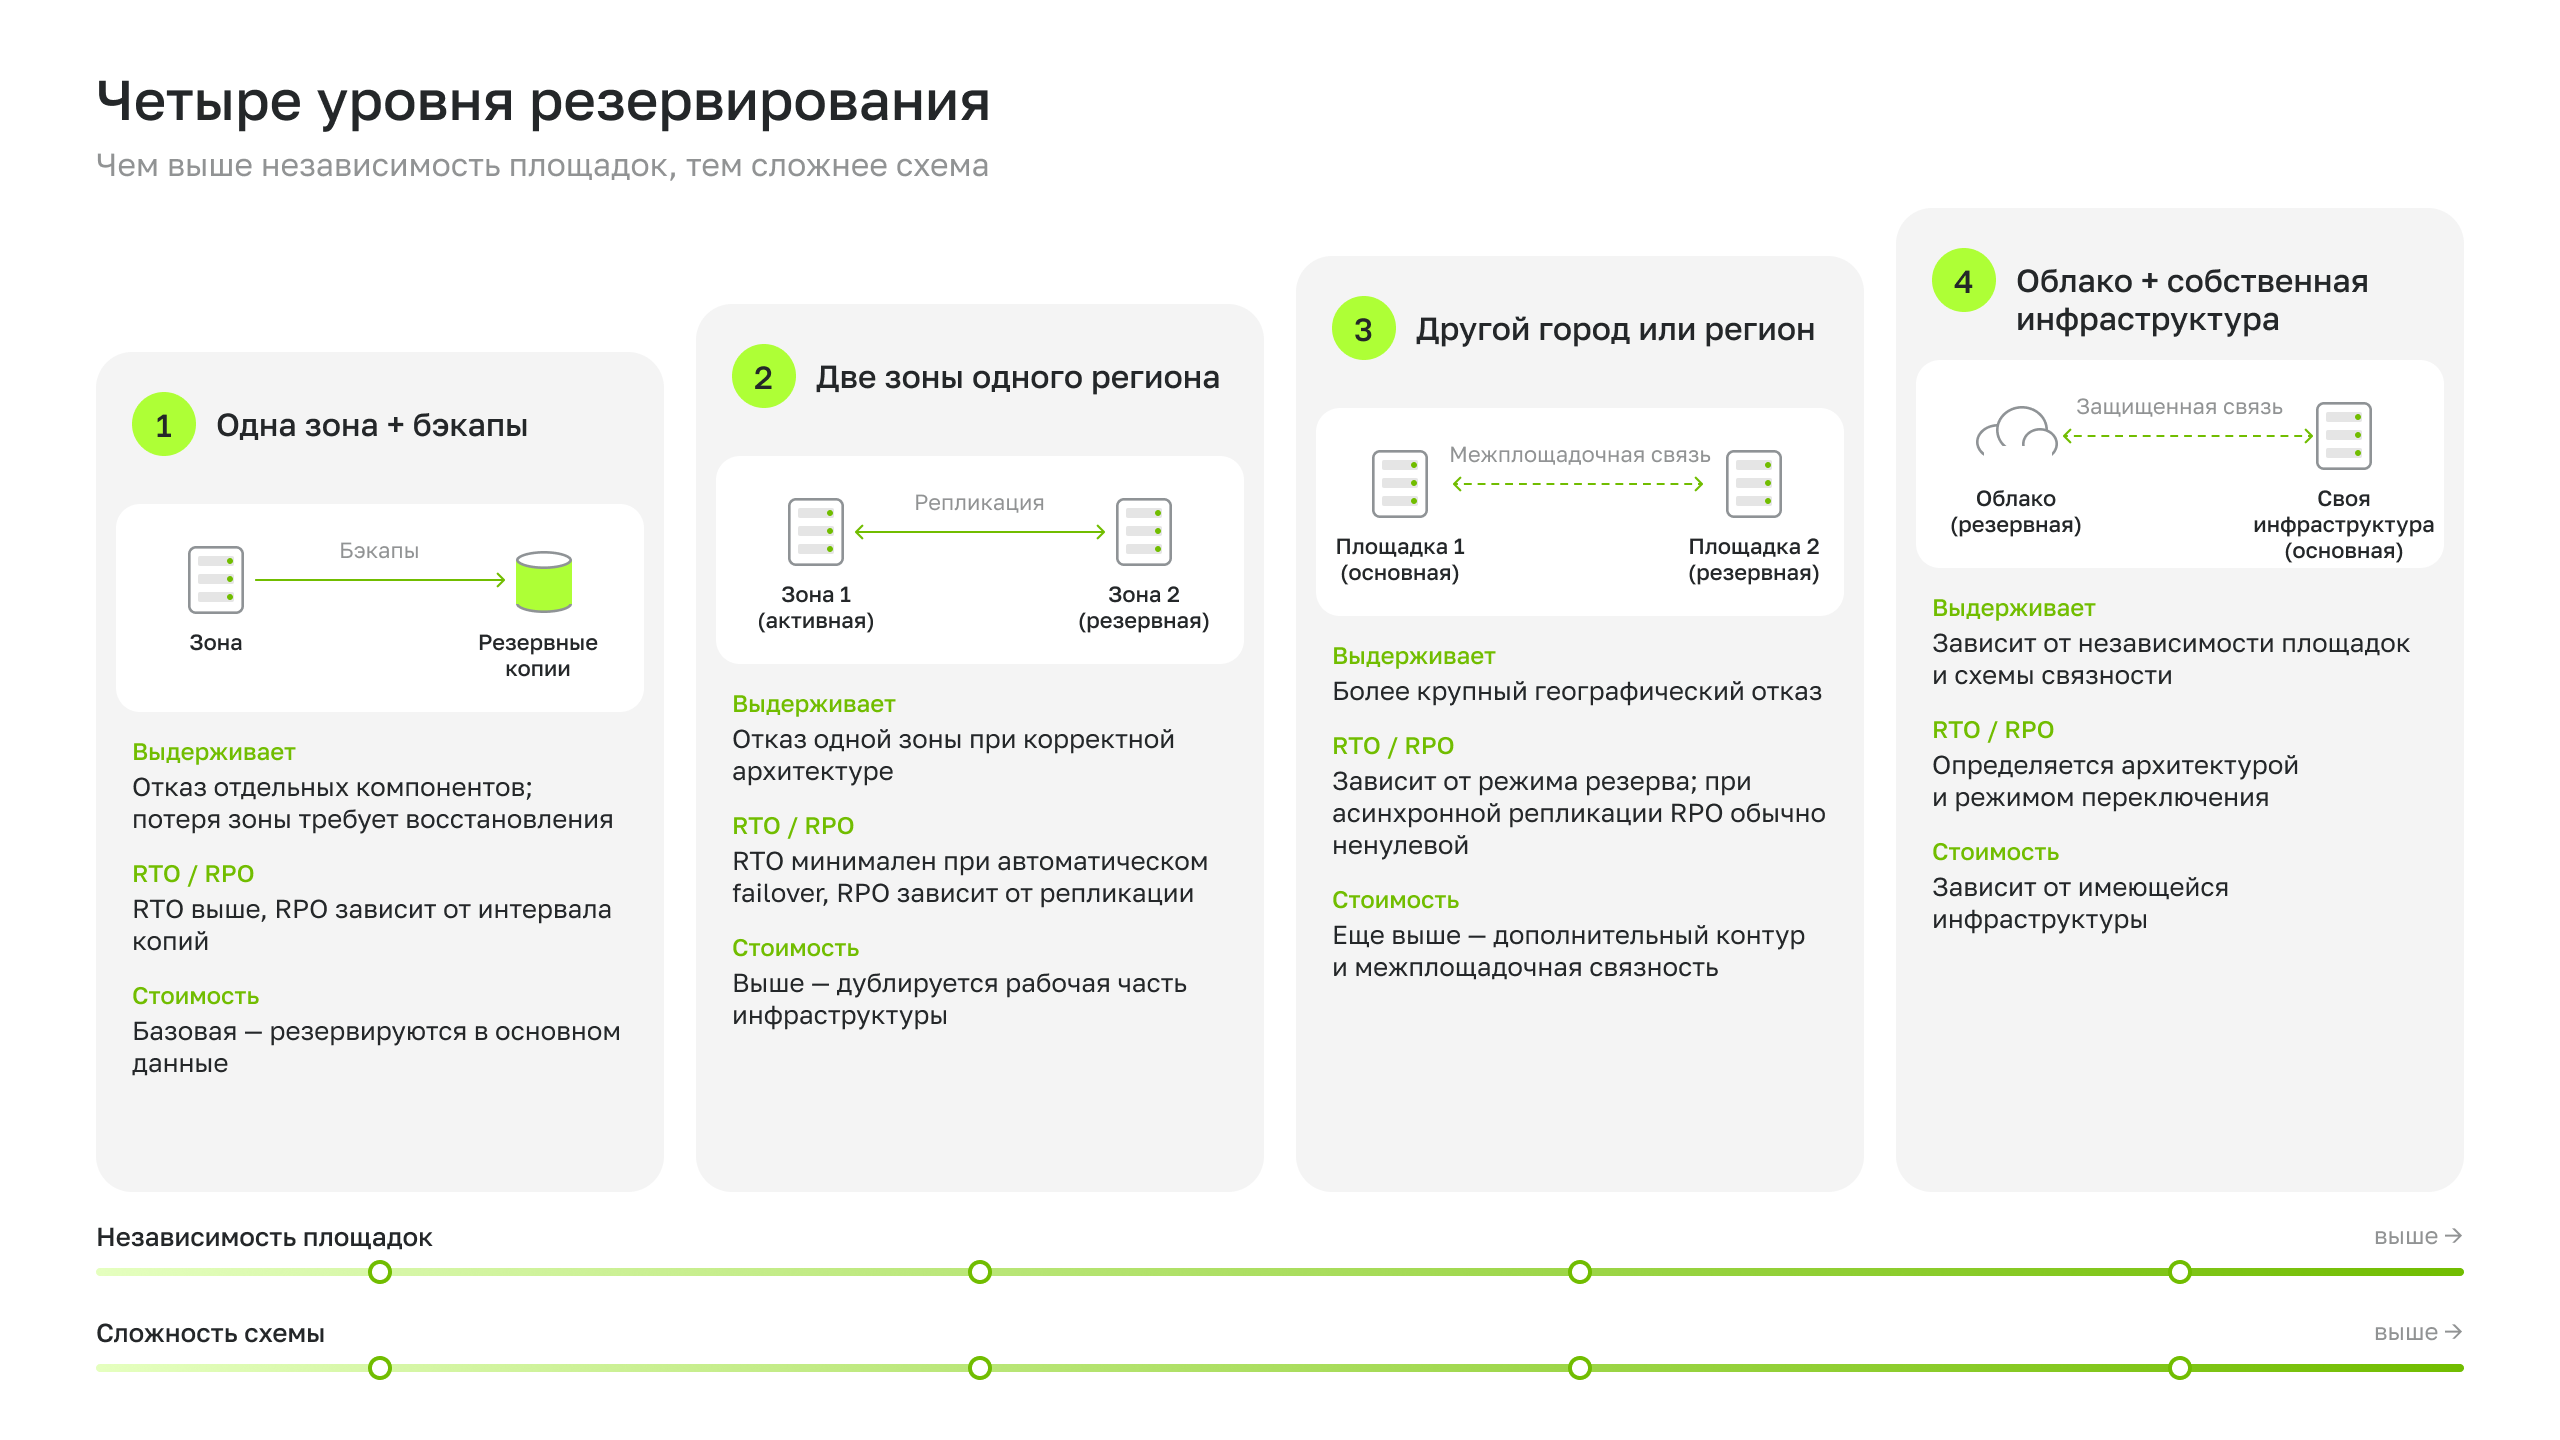
| Схема | Какой отказ выдерживает без полной остановки | RTO и RPO | Относительная стоимость |
| Одна зона + бэкапы | Отказ отдельных компонентов; потеря зоны требует восстановления | RTO выше; RPO равен интервалу между копиями | Базовая — резервируются в основном данные |
| Две зоны одного региона | Отказ одной зоны при корректной архитектуре | RTO может быть минимальным при автоматическом failover; RPO зависит от репликации | Выше — уже дублируется рабочая часть инфраструктуры |
| Другой город или регион | Отказ масштаба города или страны | Зависит от режима резерва; при асинхронной репликации RPO обычно ненулевой | Еще выше — дополнительный контур и межплощадочная связность |
| Облако + собственная площадка | Зависит от независимости площадок и схемы связности | Определяется архитектурой и режимом переключения | Зависит от имеющейся инфраструктуры |
Конкретные значения RTO, RPO и стоимости зависят от приложения. Поэтому схему выбирают, отталкиваясь от требований бизнеса: сначала фиксируют допустимый простой и допустимую потерю данных, затем проверяют, какие сценарии отказа выводят систему за эти рамки.
Почему задержка между зонами определяет архитектуру
Разнести систему по двум площадкам недостаточно: важно, как быстро они обмениваются данными. Особенно это критично для баз данных.
При синхронной репликации запись считается подтвержденной только после сохранения на основном узле и реплике. Поэтому каждая операция ждет сетевого обмена между площадками. Чем выше задержка, тем сильнее репликация влияет на время выполнения транзакций.
Внутри одного региона задержка обычно измеряется единицами миллисекунд, что позволяет рассматривать зоны как части одной распределенной системы. В пуле uz-1 задержка между uz-1a и uz-1b составляет менее 1 мс. Это делает практичными сценарии, где между зонами постоянно идет служебный трафик: репликация базы данных, работа растянутого кластера Kubernetes, вызовы между сервисами.
Между удаленными регионами задержка выше, поэтому чаще используют асинхронную репликацию: основной узел не ждет подтверждения записи на резервной площадке. Это снижает влияние сети на производительность, но означает ненулевой RPO.
Выбор режима репликации все равно зависит от конкретной СУБД, требований к консистентности и характера нагрузки. Низкая задержка создает техническую возможность для Multi-AZ, но не отменяет архитектурных ограничений приложения.
Что нужно настроить, чтобы отказоустойчивость заработала
Переезд в новую зону сам по себе отказоустойчивости не дает. Сервис должен быть заранее спроектирован так, чтобы продолжать работу после потери одной площадки.
Приложение
Критичные компоненты запускают минимум в двух рабочих экземплярах в разных зонах. Для автоматического переключения удобнее stateless-архитектура, при которой экземпляр приложения не хранит пользовательское состояние локально.
Сессии, файлы и другое состояние выносят в базу данных, кэш или объектное хранилище, которые также должны иметь собственную схему резервирования. Иначе распределенное приложение останется зависимым от одного нерезервированного компонента.
Балансировка
Балансировщик должен распределять трафик между зонами и выполнять health check — проверку состояния экземпляров. Если узел или целая зона перестают отвечать, их исключают из обработки запросов.
Сам балансировщик при этом не должен быть единой точкой отказа. Иначе приложение будет работать на обеих площадках, но входной трафик остановится вместе с единственным балансировщиком.
Сеть и маршрутизация
Балансировка и репликация не помогут, если маршрутизация остается в одной зоне. Облачный роутер — такая же единая точка отказа, как и все остальное: при недоступности площадки трафик до работающих экземпляров во второй зоне просто не дойдет.
Для этого есть резервированный (HA) роутер: он работает по VRRP и переживает отказ зоны доступности вместе с публичным плавающим IP и приватным трафиком. Ориентировочное время переключения — около 12 секунд. Тип роутера выбирается при создании и меняется в обе стороны, поэтому его стоит заложить в схему заранее, а не после первой аварии.
База данных
Для базы данных нужно выбрать синхронную или асинхронную репликацию и определить, какой узел становится рабочим после сбоя. В кластерных СУБД важно отдельно спроектировать кворум.
Нечетное число голосующих узлов помогает однозначно определить большинство, но само по себе не гарантирует устойчивость к потере зоны: нужно учитывать, как голоса распределены между площадками. Например, при схеме 2 + 1 потеря зоны с двумя голосующими узлами лишит кластер большинства.
Kubernetes
В Kubernetes недостаточно создать worker-узлы в двух зонах. Реплики одного приложения тоже нужно распределить между площадками.
Для этого используют topology spread constraints и pod anti-affinity: они не дают всем подам критичного сервиса оказаться в одной зоне. При потере площадки Kubernetes пересоздаст нагрузку на оставшихся узлах только при наличии свободной вычислительной емкости и доступных внешних зависимостей.
Данные и бэкапы
Репликация нужна для продолжения работы, но не заменяет резервные копии. Если данные удалили или ошибочное изменение разошлось по всем репликам, вторая зона получит то же некорректное состояние.
Резервные копии следует хранить независимо от продуктивного контура и предусматривать возможность восстановления при недоступности основной зоны. Для критичных данных полезен point-in-time recovery — восстановление на выбранный момент времени.
Проверка
Схему нужно проверять аварийными учениями. Смоделируйте недоступность зоны и убедитесь, что балансировщик убирает ее из трафика, база данных корректно выбирает рабочий узел, Kubernetes сохраняет необходимое число реплик, а оставшихся ресурсов хватает под нагрузку.
Отдельно зафиксируйте регламент: что переключается автоматически, где требуется ручное действие, кто принимает решение и как система возвращается в штатный режим.
Чек-лист перехода на мультизональную схему
- Определите RTO и RPO. Зафиксируйте допустимый простой и потерю данных.
- Найдите единые точки отказа. Проверьте приложение, БД, балансировщики, роутеры, очереди, кэши, хранилища, DNS и сетевые компоненты.
- Распределите экземпляры приложения между зонами. Сервис должен продолжать работу после полной потери одной площадки.
- Уберите локальное состояние из приложения. Вынесите сессии, файлы и другие критичные данные в отказоустойчивые сервисы хранения.
- Настройте балансировку, маршрутизацию и health checks. Убедитесь, что трафик автоматически исключает недоступную зону, а роутер зарезервирован.
- Спроектируйте репликацию БД. Выберите режим репликации, настройте кворум и проверьте поведение при разрыве связи между зонами.
- Распределите нагрузку в Kubernetes. Используйте topology spread constraints и anti-affinity.
- Оставьте запас ресурсов. Рассчитайте, выдержит ли оставшаяся зона критичную нагрузку.
- Храните бэкапы отдельно от продуктивного контура. Проверьте восстановление при недоступности основной площадки.
- Проведите тест failover. Зафиксируйте результат, ручные действия и ответственных.
Повторяйте такую проверку после значимых изменений архитектуры: новый компонент, оставшийся в одной зоне, может снова создать единую точку отказа.
FAQ
Чем зона доступности отличается от региона?
Зона доступности — отдельная инфраструктурная площадка внутри региона. Регион объединяет одну или несколько географически близких зон, связанных сетью с низкой задержкой. Multi-AZ строится между зонами одного региона, а мультирегиональная схема — между отдельными регионами.
Сколько зон нужно для отказоустойчивости?
Для продолжения работы при отказе одной площадки инфраструктуру как минимум распределяют между двумя независимыми зонами. Но их количество само по себе ничего не гарантирует: приложение, данные и входной трафик должны быть распределены так, чтобы система продолжила работу после потери любой из зон.
Дает ли размещение в двух зонах защиту от потери данных?
Только от части сценариев. Репликация может сохранить данные при инфраструктурном отказе площадки, но не защищает от логического удаления или повреждения, которое распространилось на все реплики. Для этого нужны бэкапы и механизмы восстановления.
Нужно ли переписывать приложение под мультизональную схему?
Не всегда. Но приложение должно работать в нескольких экземплярах и не зависеть от локального состояния одного сервера. Также нужно проверить БД, кэши, очереди, балансировщики и другие зависимости: любой компонент, оставшийся в одной зоне, может стать единой точкой отказа.
Растет ли задержка, если разнести кластер между зонами?
Да, физическое разделение площадок добавляет сетевую задержку. Внутри одного региона она обычно достаточно мала для тесно связанных компонентов: в uz-1 между uz-1a и uz-1b — менее 1 мс. Влияние на приложение нужно проверять под реальной нагрузкой.
Сколько стоит резервирование во второй зоне?
Универсальной цифры нет. Стоимость зависит от количества резервируемых компонентов, объема вычислений и хранения, режима репликации и того, работает ли резерв постоянно. Сравнивать ее стоит с допустимой стоимостью простоя конкретного сервиса.
Достаточно ли создать копии виртуальных машин во второй зоне?
Нет. Они должны получать актуальные данные и быть включены в рабочий сценарий переключения. Без репликации, балансировки, health checks и проверенного failover это запас ресурсов, а не отказоустойчивая схема.
Заключение
Уровень резервирования выбирают исходя из допустимого времени простоя, требований к сохранности данных и бюджета, а не как отдельную инфраструктурную опцию. Multi-AZ снижает зависимость от одной площадки, если приложение, данные и сетевые компоненты действительно распределены между зонами и failover проверен на практике.
Инженеры Servercore помогут оценить текущую архитектуру, выбрать схему резервирования и спланировать переход на мультизональное размещение.